
但凡用过本地大模型的朋友,心里都有本账:7B、14B 的模型本地跑得挺欢,可一旦把参数堆到千亿级,那就是另一个故事了——那是服务器机房里几百 GB 显存的活儿,跟我们桌面上的显卡没什么关系。所以当五哥看到 Strata 这个项目的时候,第一反应是"又来画饼的",第二反应是"等等,它真跑起来了"。
它的官方副标题写得非常嚣张:
Run a 125-billion-parameter AI model on your own gaming PC
翻译过来就是:在你自己的游戏电脑上,跑 1250 亿参数的 AI 模型。NVIDIA 或 AMD 显卡、12 GB 显存起步、Windows 或 Linux、免费开源。更离谱的是它的增长速度——项目 2026 年 9 月 24 日建仓,到现在半个多月,GitHub 已经 21885 Star、2089 Fork、244 位贡献者,最高频的时候一天好几个版本(最新 v0.1.43,10 月 11 日刚发)。
划四个重点:
- 🧠 125B 的模型塞进 12GB 显存——靠"把工作摊到整台电脑上",显卡、内存、CPU、SSD 各干一段;
- 📦 一键安装——Windows 双击
START-HERE.bat,Linux 跑./setup.sh,装完浏览器自动打开; - 🔌 本地 API 直接接管你的工具链——OpenAI / Anthropic 双协议兼容,Claude Code、Cursor、Codex 填个地址就能用;
- 🔒 数据不出本机——MIT 开源,模型、对话、图片全在你自己的硬盘上。
📌 Strata 到底是什么?
一句话:一个为消费级硬件重写的 MoE 大模型推理引擎,作者是 GitHub 用户 Niko1221。
它跑的不是什么"小模型特供版",而是正经的 Qwen3.8-Flash-Next——阿里 Qwen 团队 2026 年 8 月推出的多模态混合专家(MoE)模型,1250 亿参数,另外还挂着一张 51B 参数的 n-gram 嵌入表,原生 262K 上下文。这种规格的模型平时躺在什么机器上?几百 GB 显存的推理服务器。
Strata 把它拖回了你的桌面。引擎本身是 C++ / CMake + ggml 写的,后端同时支持 CUDA(NVIDIA)、HIP / ROCm(AMD)、SYCL(Intel Arc)三套,协议为 MIT,仓库里连中文、日文、德文、法文、西语、葡语在内的 7 种 README 都配齐了——这个国际化程度,在个人项目里相当少见。
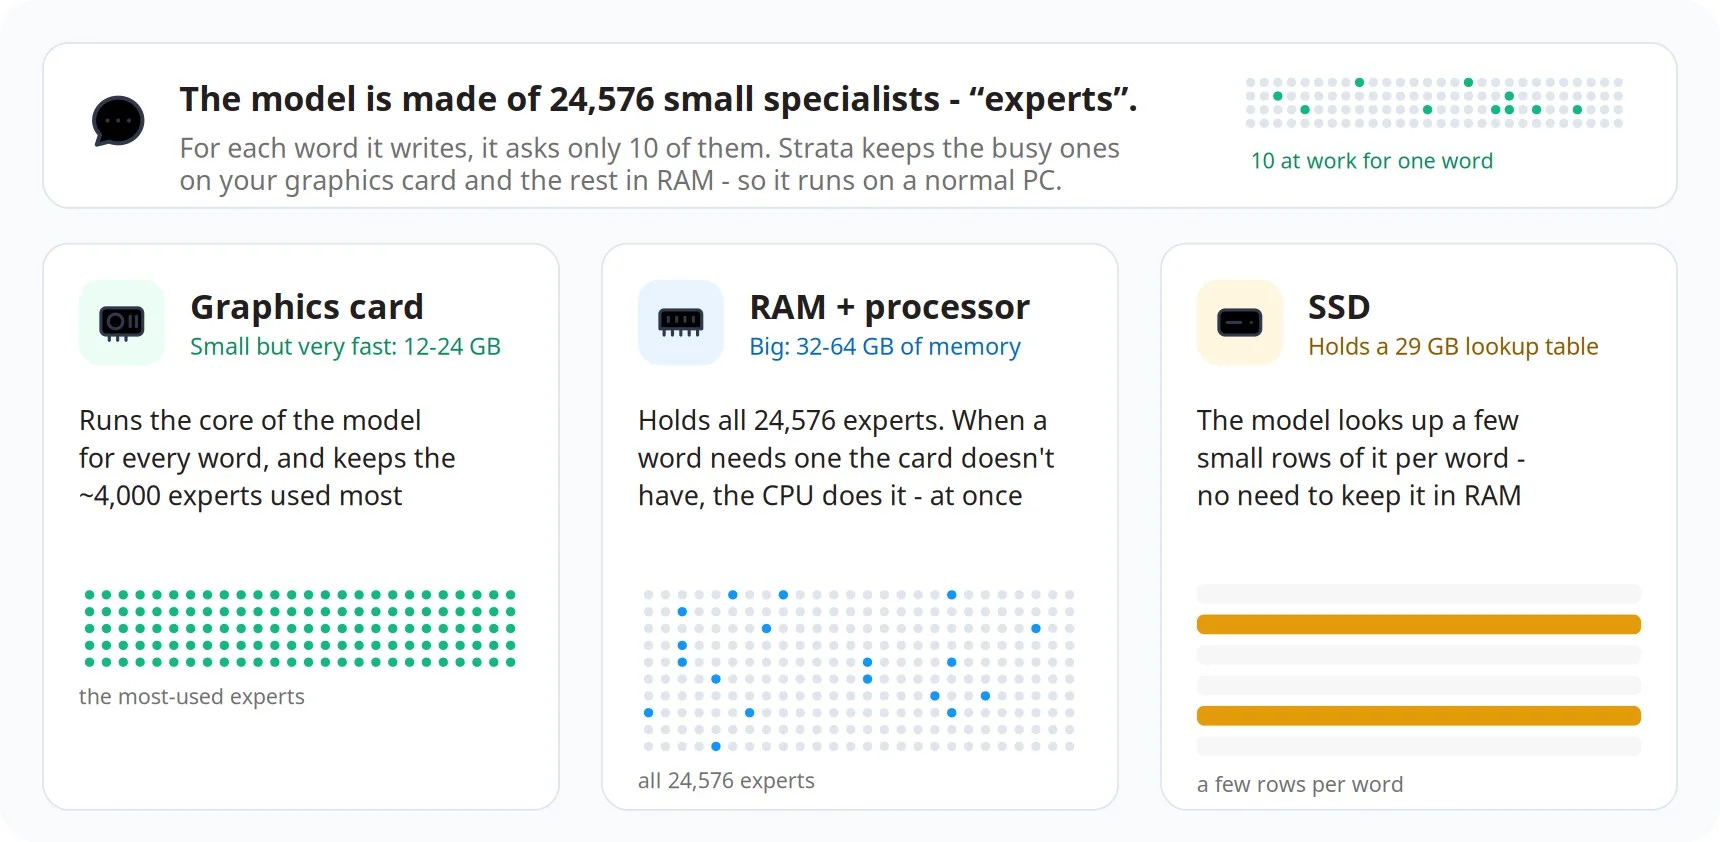
🚀 它是怎么塞进去的?把工作摊到整台电脑上
要让 125B 的模型在 12GB 显存上跑起来,硬塞是塞不进去的。Strata 的思路很朴素,用官方的话说——像厨房:常用的锅铲放在台面上,其余的进储藏室。落到技术上,就是把模型的三大块工作分给整机的三块硬件。
关键前提是:Qwen3.8-Flash-Next 是个 MoE 模型,由 24576 个"小专家"组成,而写每一个词只需要其中 10 个。既然不需要同时用到全部专家,那就有了腾挪空间。
| 硬件 | 负责什么 |
|---|---|
| 显卡(VRAM) | 注意力与 DeltaNet 混合层、路由、共享专家、输出头、MTP 草稿层、KV 缓存,剩下显存全用来缓存调用最频繁的专家(约每 GB 显存装 700 个专家,且会随着你的聊天内容自动调整) |
| 内存(RAM) | 常驻全部 24576 个专家。显卡上没有的专家,由 CPU 就地计算(AVX-512 / AVX2 内核),和显卡并行,谁也不等谁 |
| 固态(SSD) | 存放 28.8 GB 的 n-gram 查找表,每个词只读其中几行 |
光这样还不够快,所以 Strata 还上了两招。
第一招:先猜,再检查(投机解码)。模型自带的 MTP 草稿层先猜接下来几个词,大模型一次把猜的一起核对,同意哪些就留哪些。一招下来,一次前向能产出 2.4 到 3.2 个 token,官方实测提速 1.6 到 1.8 倍——而因为最终每个词还是大模型拍的板,答案质量一点不打折。如果回答在复述你的上下文(改代码、引用原文),它还会从原文里直接"抄"草稿,代码编辑场景再快 6-11%。
第二招:长文本分大块读。一次最多吃进 8192 个 token,边读这一层的注意力边通过 PCIe 把下一层的专家流式搬上显卡,所以长文档、代码库的读取速度能过每秒 1000 token。第一段读完之后只读新增内容,所以追问几乎是秒回。
💡 一个反直觉的点:显存大比显卡快更重要。每多 1GB 显存就能多装约 700 个专家,而装在显卡上的每一个专家,都是 CPU 不必再算的那一个。所以 RTX 3090 的 24GB,比一张跑分更高的 12GB 新卡更吃香。
⚡ 跑分实测:两台"普通游戏电脑"的成绩单
官方在两台常规配置上做了完整测试。表格里有两列指标,先解释清楚:"写回答"是短对话里回复冒出来的速度(每秒 60 个 token 就已经比人阅读速度快了);"读提示"是吃进你发过去的内容的速度,这里测的是一份 32K token 的文档 / 代码 / 聊天记录。
NVIDIA 平台:RTX 5070(12 GB)+ Ryzen 5 7600 + 64 GB 内存
| 规格 | 写回答 | 读提示 |
|---|---|---|
| Q2_0 | 94 tokens/s | 2,650 tokens/s |
| IQ2_XS | 79 tokens/s | 2,090 tokens/s |
| IQ3_XXS | 62 tokens/s | 1,750 tokens/s |
| IQ3_S | 53 tokens/s | 1,620 tokens/s |
| Coder | 55 tokens/s | 2,180 tokens/s |
AMD 平台:RX 9070 XT(16 GB)+ Ryzen 9 3900X + 47 GB 内存
| 规格 | 写回答 | 读提示 |
|---|---|---|
| Q2_0 | 60 tokens/s | 1,160 tokens/s |
| IQ2_XS | 52 tokens/s | 1,110 tokens/s |
| Coder | 44 tokens/s | 1,420 tokens/s |
官方给的其他显卡估算(同样 CPU、64GB 内存,误差范围约 ±20%):
| 显卡 | 规格 | 写回答 |
|---|---|---|
| RTX 3090(24 GB) | Q2_0 | 约 128–140 tokens/s |
| RTX 5060 Ti(16 GB) | Q2_0 | 约 80–87 tokens/s |
| Tesla P40(社区实测) | IQ3_S | 30–33 tokens/s |
另外,官方在 RTX 3090 上跑 Coder 提到过一组很有意思的数字:198K 上下文下输出 99 tokens/s(对比默认设置的 85),长上下文也不怎么掉速。
📝 数据口径说明:NVIDIA 的 Q2_0 行用的是引擎 0.1.36,其余各行用的是 0.1.26(4K 回答、32K 提示)。8 GB 显卡官方也说了"能跑,但慢"。完整表格和长上下文数据在
docs/DETAILS.md。
🖥️ 你需要什么样的电脑?
| 项目 | 要求 |
|---|---|
| 显卡 | NVIDIA RTX 20 / 30 / 40 / 50 系列,或 AMD RX 7900 XT/XTX、7800 XT、7700 XT、9060 XT、9070/9070 XT、Radeon AI PRO R9700、RX 6800/6900 系列。12 GB 显存以上(8 GB 能跑但慢) |
| 内存 | 32 GB 起步,64 GB 推荐。内存大小 = 能装下哪个规格 |
| 硬盘 | 约 70–80 GB 可用空间(模型本体),外加约 6 GB 的 MTP 草稿层。强烈建议 NVMe SSD |
| 处理器 | x86-64 且支持 AVX2(近 8 年的 Intel / AMD 桌面 CPU 都行),AVX-512(锐龙 7000/9000)会快一点 |
| 系统 | Windows 10 / 11 或 Linux,只需要装好最新的显卡驱动 |
有意思的是它的实验性硬件清单,全是社区成员在自己机器上写出来、跑通的:特斯拉 P40 / P100 / V100、GTX 10 系、Radeon VII / MI50、RX 6700 XT、RX 5500 XT,Intel Arc(需在 Linux 上从源码构建),AMD Ryzen AI Max(Strix Halo),甚至不支持 AVX2 的老 CPU。一个个人项目能把老硬件生态照顾到这个份上,挺不容易。
📦 安装:要么让 AI 帮你装,要么双击一个文件
Strata 给了两条路,而且第一条相当有时代特色。
路子一:让你的 AI 编程助手帮你装。如果你在用 Claude Code、Cursor、Codex、GitHub Copilot 之类,直接把下面这句话粘给它:
Set up Strata on this PC for me: https://github.com/Niko1221/Strata - follow docs/AI_SETUP.md in that repository.它会自己检查你的显卡、内存、硬盘,选出合适的模型规格,然后安装、启动,再告诉你怎么接进应用。Strata 还提供了 MCP 服务器,让 AI 工具能直接启停这个引擎。
路子二:自己动手,就两步。
# Windows:解压后双击
START-HERE.bat

# Linux:在 Strata 目录下
./setup.sh
NVIDIA 和 AMD 的步骤完全一样,安装程序会识别显卡并装好对应引擎。它只问你四个问题——用哪个模型、哪个规格,上下文多大,要不要识别图片——每次直接回车就是推荐选项。然后开始下载模型(约 70 GB),中途断了再跑一次会续传。
⚠️ 第一次启动时电脑会卡 1–3 分钟,这是正常的。Strata 要把 35–55 GB 内容加载进内存,并为显卡锁定其中一部分。别关窗口,别强制断电,窗口里会实时显示它在干什么。之后再用就秒开了。
🧩 该选哪个规格?按内存对号入座
同一个模型被压成了几种"规格",压得越狠越快、越不狠越聪明。
| 你的内存 | 建议选择 | 原因 |
|---|---|---|
| 32 GB | Coder | 32 GB 唯一装得下的规格,专为代码打造(若显卡 24 GB,Q2_0 和 IQ2_XS 的低内存模式也能跑) |
| 48 GB | IQ2_XS(或 Q2_0,最快) | 更大的规格装不下 |
| 64 GB | IQ2_XS(推荐),或 IQ3_XXS / IQ3_S | 所有规格都能装;IQ3_S 质量最好,也最慢 |
| 96 GB 以上 | IQ3_S,或 Unsloth 的 UD-IQ4_XS(约 4-bit) | 有空间放下最大规格,开着别的程序也不虚 |
四个规格的定位一句话说清:
- Q2_0(37.6 GB)——最快,质量还行;
- IQ2_XS(39.2 GB)——快,质量更好,官方主推;
- IQ3_XXS(47.0 GB)——慢一些,质量很好;
- IQ3_S(54.8 GB)——最慢,最好,官方称在公开测试上追平完整模型。
除了规格,还有几个"版本":
- Coder:ISTA-DASLab 出的编程特化版,每层 512 个专家只留 256 个(按代码数据挑的)。据其作者测得,达到完整模型 SWE-bench Verified 分数的 91%、LiveCodeBench 的 99%,而 shard 1 只有 29.6 GB,32 GB 内存就能跑。但代价要讲明白——专家砍了一半,代码以外的能力明显变弱,中文和其他中日韩文本尤其吃亏(官方 issue #438 明确记录:中文回答会出现答错或循环)。所以除非你确实只拿它写代码,否则内存够就别选它。
- Swift 1.5:UkisAI 的微调版,回答前思考时间短得多,你能更早拿到答案,质量基本不变。
- Unsloth UD-IQ4_XS(约 4-bit):质量介于 IQ3_S 和 UD-Q4_K_XL 之间,下载 94 GB;内存不到约 80 GB 时,回答过程中要现从 SSD 读一部分专家,会慢(NVMe SSD 有救)。
- Unsloth UD-Q4_K_XL(实验性):最接近完整模型,但 111 GB 下载、77 GB 专家装不进内存,64 GB 的机器上只能跑到 7–8.5 tokens/s,属于"能跑但别指望流畅"。
🔌 怎么用:一套 API 接管你所有 AI 工具
浏览器里直接用。打开 http://127.0.0.1:8080,界面分三块:Chat(聊天,对话记录只存在浏览器本地,清理站点数据就没了)、Monitor(实时看模型在干什么,以及 GPU / CPU / 内存 / 显存占用)、About(设置与地址)。
接进你的应用和编程智能体。这也是 Strata 最实用的地方——它在 localhost 上同时提供两套主流协议:
| 你的工具 | 怎么填 |
|---|---|
| 任何"OpenAI 兼容"应用 | base URL 填 http://127.0.0.1:8080/v1,API key 和模型名随便填 |
| Claude Code(Anthropic 协议) | ANTHROPIC_BASE_URL=http://127.0.0.1:8080,或 http://127.0.0.1:8080/v1/messages |
| Codex CLI / OpenAI Responses API | 端点 /v1/responses |
思考强度可调。聊天菜单或应用的 "reasoning effort" 里能选 off / low / medium / high——off 最快,high 最适合难题。
看图。安装时对 "Images?" 选是,就能在聊天里点 Picture 传图片。图像编码器(0.9 GB)可以跑在 GPU(每张 0.1–0.5 秒,占用约 1.4 GB 显存)或 CPU(每张 3–13 秒)。注意:AMD 显卡在 Linux 上靠 CPU 识别图片,Windows 上目前还不支持看图。
从手机访问。START-HERE.bat --setup --host 0.0.0.0 --api-key <你的密钥>,一定要设密钥。
并发与长文本的坑也提前说清:默认一次只回答一个请求,后面的排队;想同时回答多个要设 "parallel": 2,但在 12 GB 显卡上每个回答都会变慢。长提示方面,第一条消息会被完整读入,大约每 3 万 token 需要 1 分钟,之后的消息几秒内就开始出字。
另外,Strata 还导出一套 Prometheus 指标(连 vLLM 和 llama.cpp 的指标名都兼容了),官方在 docs/monitoring/ 里直接给了 prometheus.yml、ServiceMonitor 和一份现成的 grafana-strata.json 仪表盘——这已经不是"玩具项目"的做法了。
🚨 上手动之前,这几点要先知道
- 内存是硬门槛,不是显存。最扎心的一个事实:显卡再大也降不下来内存要求(除非用低内存模式)。64 GB 内存能装下全部规格,48 GB 只能装 Q2_0 / IQ2_XS,32 GB 就只有 Coder。想升级,先看内存条。
- 磁盘要留够,而且最好是 NVMe。模型本体 70–80 GB,加上 MTP 草稿层约 6 GB;如果内核要现场编译,还要额外占空间。而且内存不足时专家会从 SSD 现读,这时候 NVMe 和 SATA 盘的差距会非常直观。
- 中文用户注意 Coder 的短板。前面强调过——Coder 为了塞进 32 GB 砍掉了一半专家,中文能力是明确被牺牲掉的那部分。要中文对话、要写作,选保留全部专家的 Q2_0 / IQ2_XS / IQ3_S。
- 还在快速迭代期。半个多月冲到 2.1 万 Star,同时开着 749 个 issue,版本号一天一跳(0.1.40.2 → 0.1.40.3 → 0.1.40.4 这样的热修很常见)。这是好事(更新勤),也是风险(新版本偶尔引入回归)。用
UPDATE.bat更新很方便,但生产用途建议观察一两天再跟。 - AMD 用户的功能落差。Windows 上的 AMD 走预编译 HIP 引擎,不用装 ROCm、不用编译器,这很香;但看图功能 Windows 上暂时缺席,要等后续版本。
🎯 总结
本地跑大模型这件事,过去两年一直在"小模型凑合用"和"云 API 交月费"之间摇摆。Strata 给出的是第三条路:把千亿参数的模型拆开,摊到你已经拥有的整台电脑上。它没打算赢过 8 卡服务器,它要赢的是"我为什么还得把代码和文档传给别人的服务器"这个念头。
如果你是下面这几类人,值得花一个晚上折腾:
- 💻 手上有 12GB 以上显卡、64GB 内存的游戏 PC,闲着也是闲着;
- 🔐 对数据敏感,代码、合同、客户资料一个字都不想上传;
- 🤖 Claude Code / Cursor / Codex 重度用户,想试试"API 就在自己机器上"是什么体验;
- 💰 想算一笔账:一次性投入的硬件 vs 每个月滚动的 API 账单。
反过来,如果你的电脑是 16 GB 内存 + 8 GB 显存,那还是先别折腾了——官方说得客气,"能跑,但很慢",实际体验大概会让你怀疑人生。
🔗 GitHub:github.com/Niko1221/Strata
🔗 中文文档:README.zh-CN.md
🔗 模型:Qwen3.8-Flash-Next(Hugging Face)
显存买不来千亿模型,但把工作摊开这件事,是可以的。
— 墨涩